Archlab ChampSim Project 1 Report #
Part 1 - Deliverables #
-
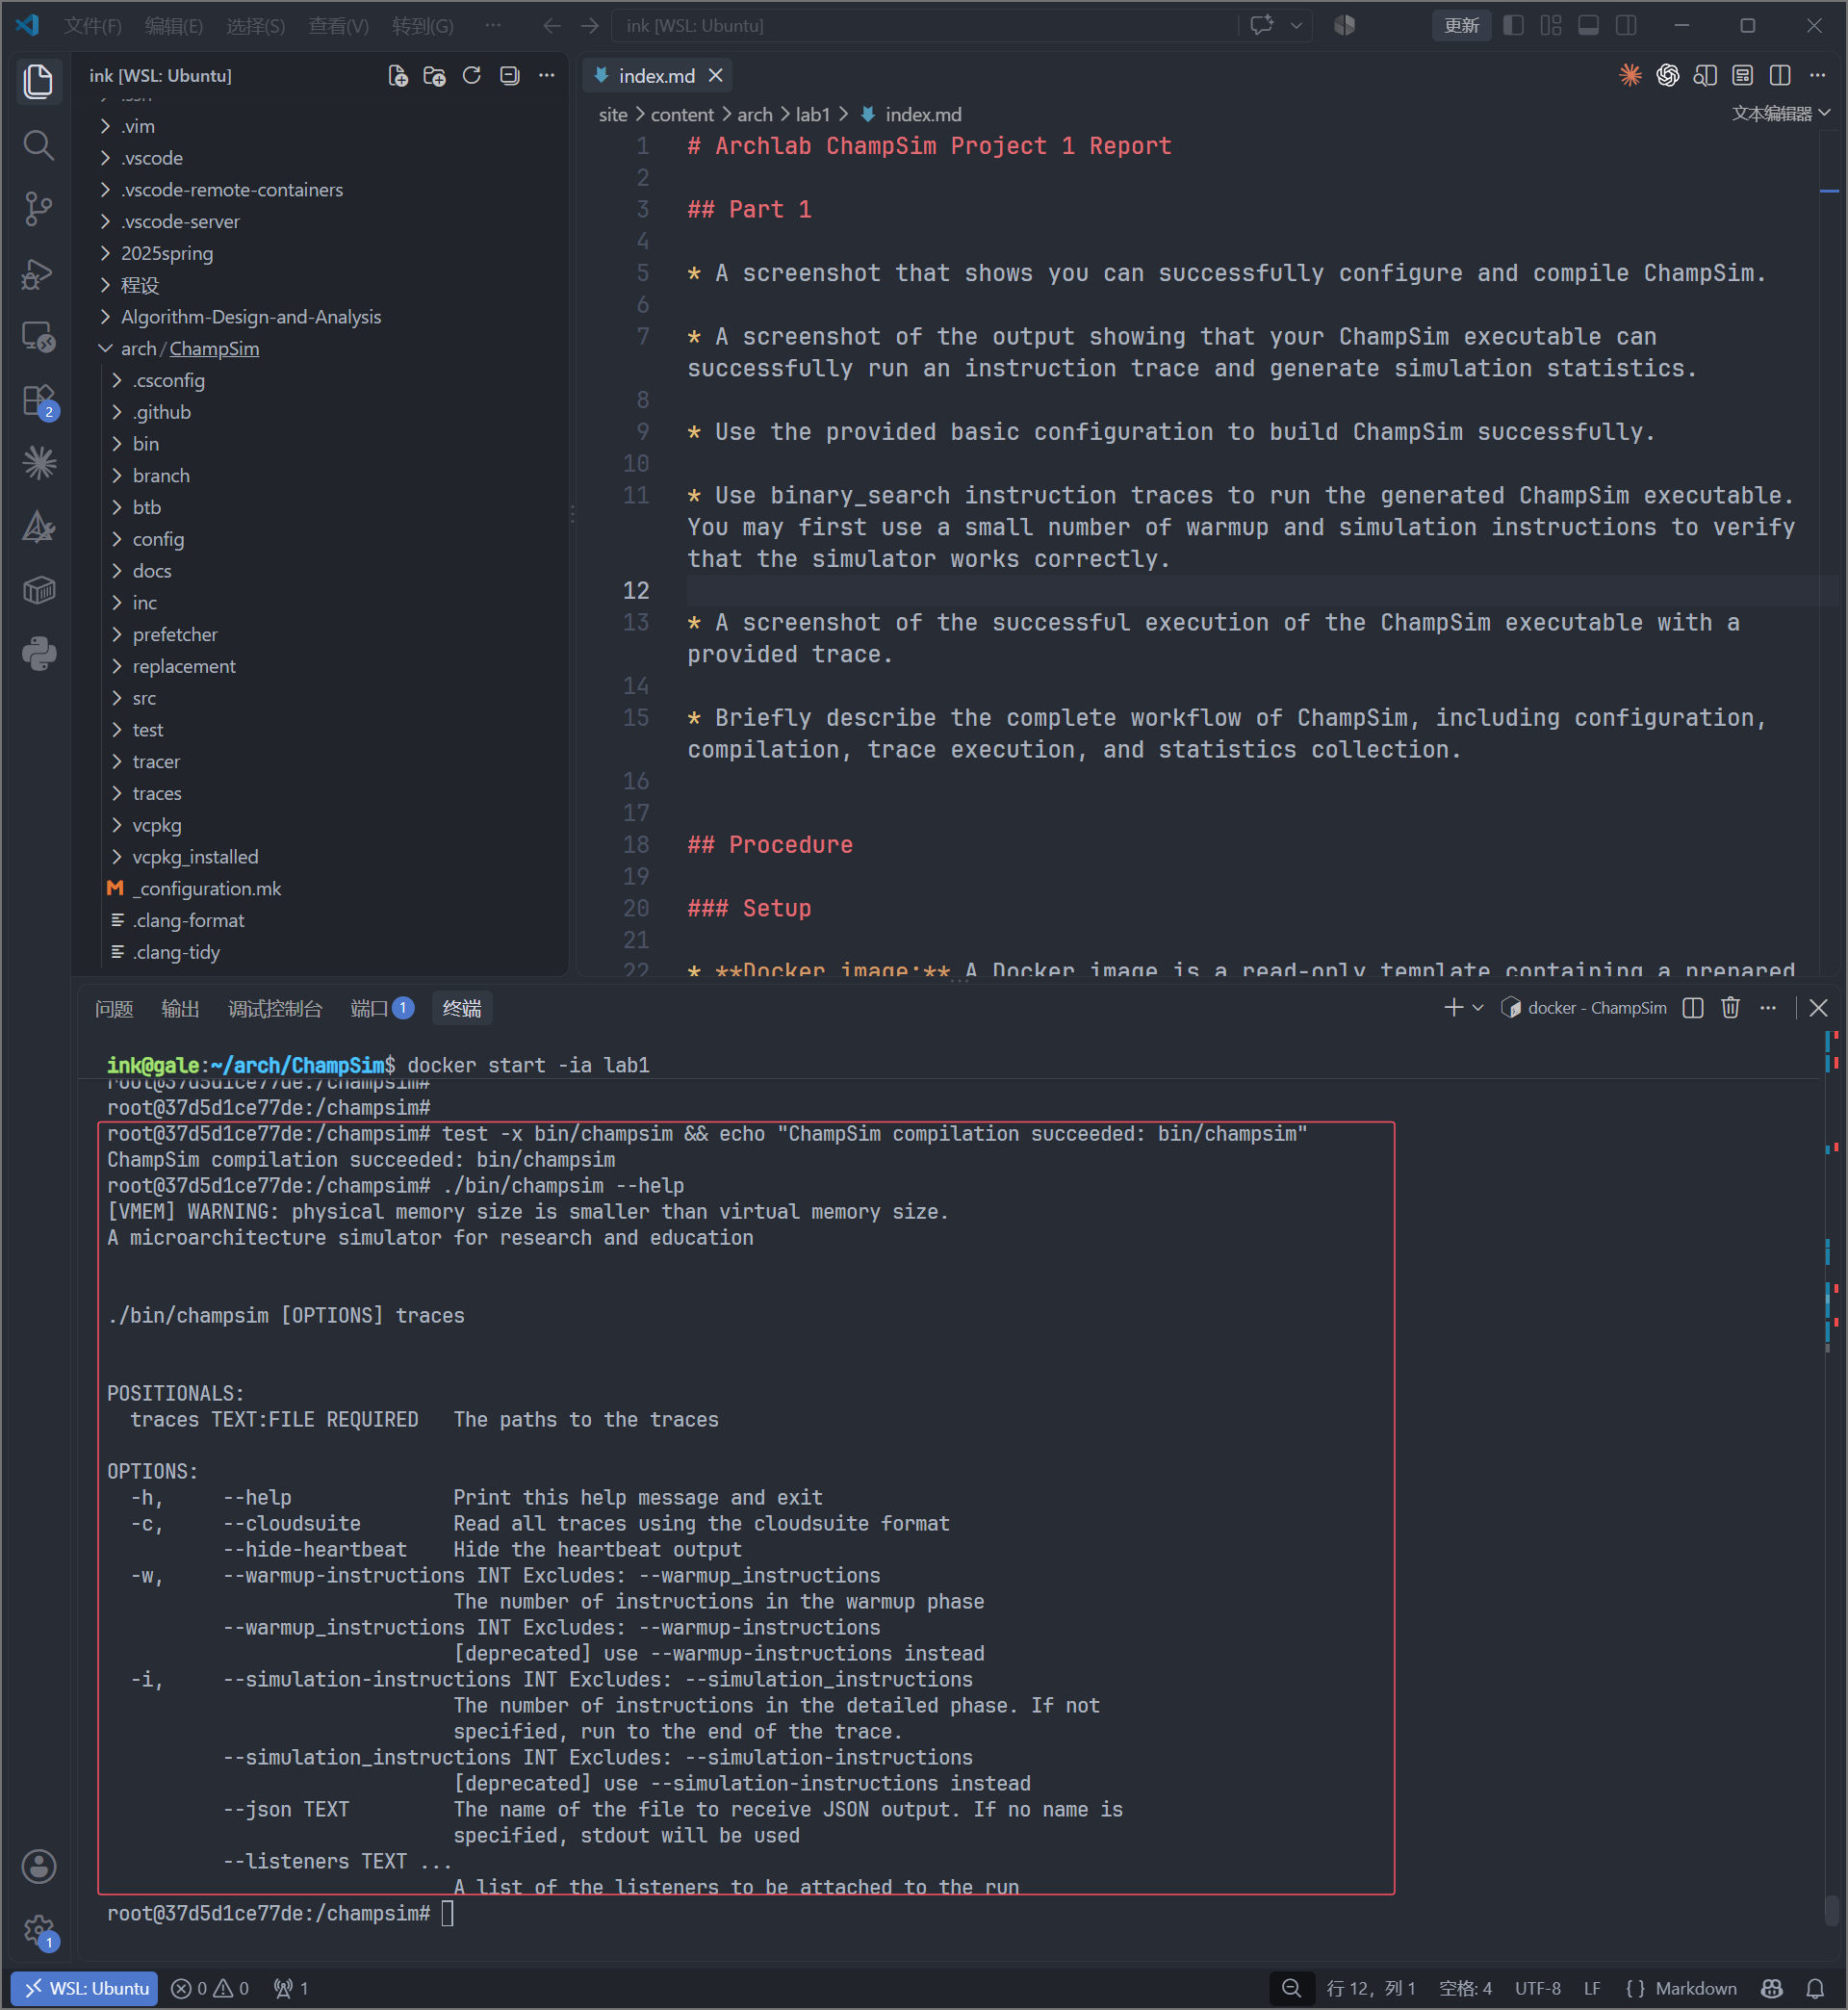
A screenshot that shows you can successfully configure and compile ChampSim.
-
A screenshot of the output showing that your ChampSim executable can successfully run an instruction trace and generate simulation statistics.
-
Use the provided basic configuration to build ChampSim successfully.
-
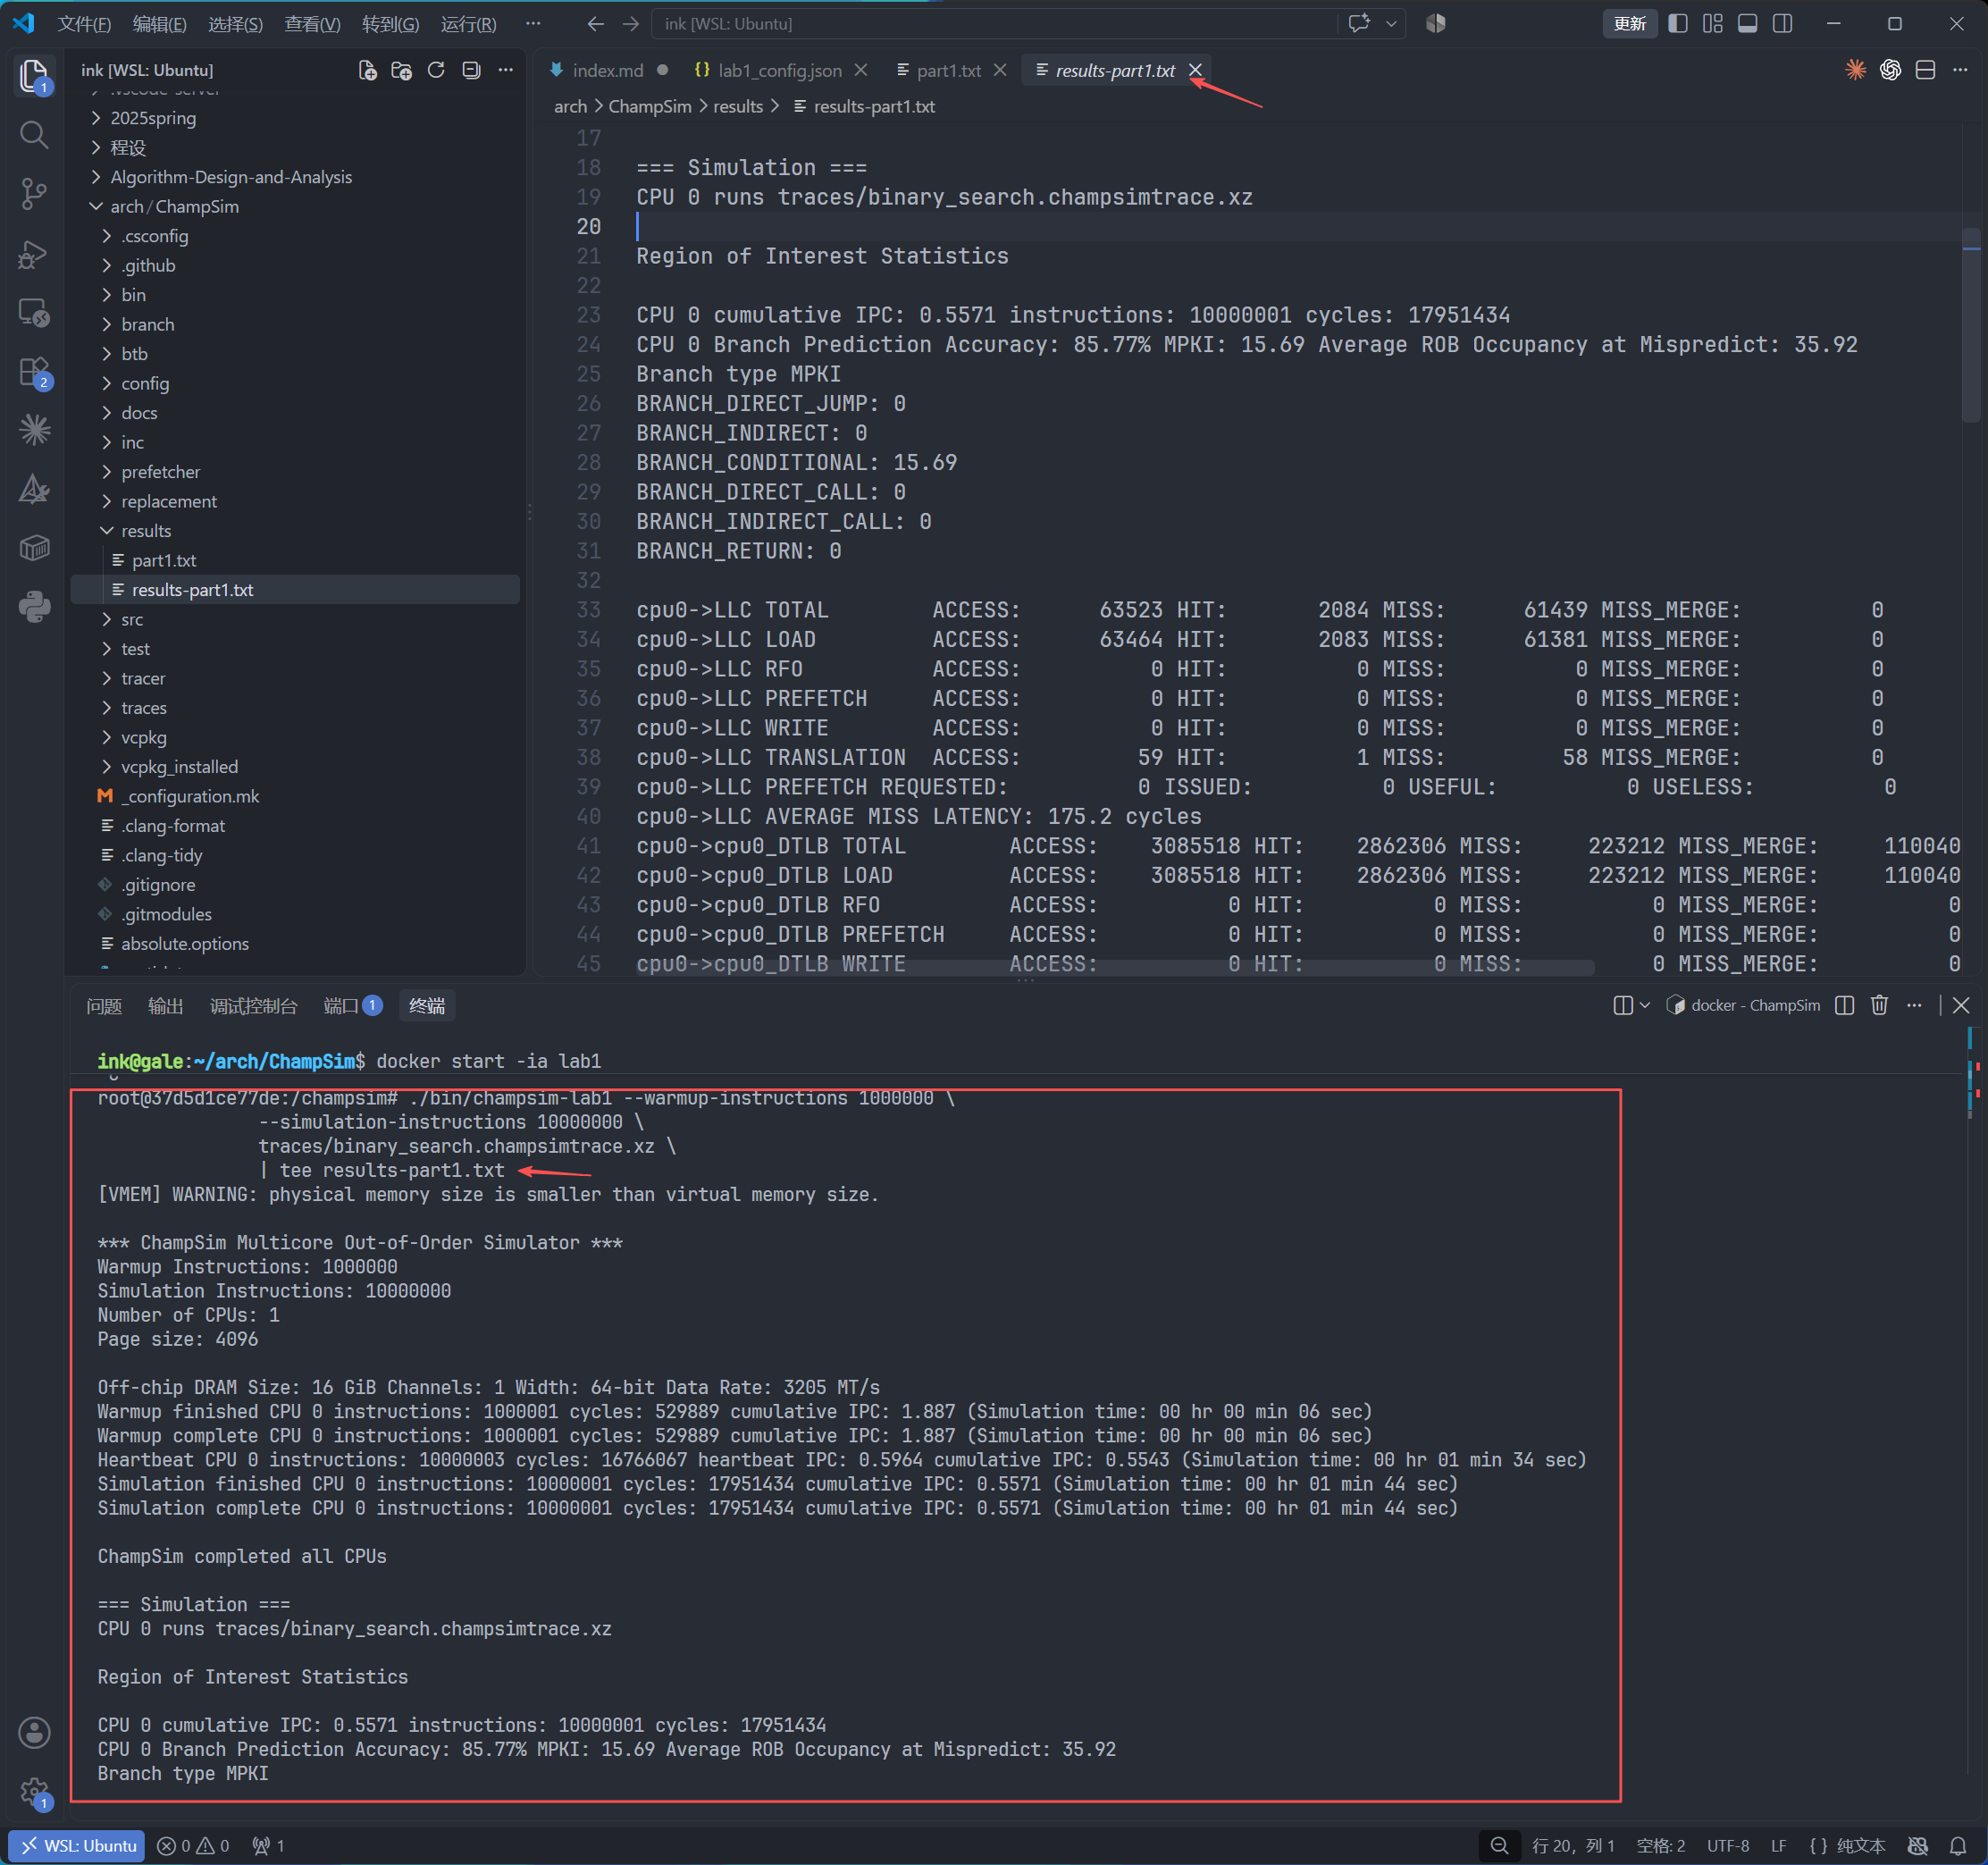
Use binary_search instruction traces to run the generated ChampSim executable. You may first use a small number of warmup and simulation instructions to verify that the simulator works correctly.
-
A screenshot of the successful execution of the ChampSim executable with a provided trace.
-
Briefly describe the complete workflow of ChampSim, including configuration, compilation, trace execution, and statistics collection.
Part 1 - Procedure #
环境准备 #
-
镜像(Image):包含系统环境和开发工具的只读模板。本实验使用
lldary/archlab-champsim:v0.3,通过docker pull下载。 -
容器(Container):由镜像创建的运行环境,本实验在容器内安装依赖、编译和运行 ChampSim。
进入容器中的 ChampSim 源码根目录后,执行依赖准备命令:
git submodule update --init
vcpkg/bootstrap-vcpkg.sh
vcpkg/vcpkg install
配置模拟器 #
ChampSim 是基于指令轨迹(trace)的微体系结构模拟器。它读取程序预先采集的指令及访存记录,模拟指令在处理器流水线和存储层次中的行为,并统计执行周期、分支预测和缓存访问情况。
本实验通过读取JSON文件来获得用户配置的处理器参数信息,该lab使用的是 lab1_config.json 来描述模拟硬件:
{
  "executable_name": "champsim-lab1",
  "ooo_cpu": [
    {
      "frequency": 4000,
      "ifetch_buffer_size": 64,
      "decode_buffer_size": 32,
      "dispatch_buffer_size": 32,
      "register_file_size": 128,
      "rob_size": 352,
      "lq_size": 128,
      "sq_size": 72,
      "fetch_width": 6,
      "decode_width": 6,
      "dispatch_width": 6,
      "execute_width": 4,
      "lq_width": 2,
      "sq_width": 2,
      "retire_width": 5,
      "branch_predictor": "hashed_perceptron",
      "btb": "basic_btb"
    }
  ],
  "L1I": {
    "sets": 64,
    "ways": 8,
    "mshr_size": 16,
    "prefetcher": "no",
    "replacement": "lru"
  },
  "L1D": {
    "sets": 96,
    "ways": 8,
    "mshr_size": 16,
    "prefetcher": "no",
    "replacement": "lru"
  },
  "L2C": {
    "sets": 2048,
    "ways": 16,
    "mshr_size": 20,
    "prefetcher": "no",
    "replacement": "lru"
  }
}- CPU 与指令流水线
ooo_cpu 配置乱序执行处理器(Out-of-Order CPU)。本实验只有一个 CPU 配置项,模拟单核处理器,frequency: 4000 表示频率为 4 GHz。指令依次经历取指、译码、分派、执行和退休等阶段;流水线让多条指令同时处于不同阶段,超标量设计则允许每个阶段在一个周期内处理多条指令。
fetch_width、decode_width 和 dispatch_width 均为 6,表示每周期最多取指、译码和分派 6 条指令;execute_width 为 4,retire_width 为 5。取指、译码和分派缓冲区容量分别为 64、32、32,用于暂存等待后续处理的指令。宽度决定每周期的处理上限,容量决定可以积压多少工作;遇到数据依赖或缓存未命中时,实际吞吐量会低于这些上限。
乱序执行与在途指令 #
乱序执行允许不依赖前面结果的指令提前执行。例如,一条加载指令正在等待内存,后续独立的加法仍可先执行。为了保持程序语义,指令最终需要按程序顺序退休,即正式提交结果。rob_size: 352 配置重排序缓冲区(ROB),用于跟踪最多 352 条尚未退休的指令。
register_file_size: 128 配置内部寄存器分配容量。乱序处理器通过寄存器重命名,为同名寄存器的不同次写入分配不同的物理存储位置,消除仅由寄存器名字重复造成的依赖。lq_size: 128 和 sq_size: 72 则分别配置加载队列、存储队列,用于跟踪读写内存的指令;对应的 lq_width、sq_width 均为 2,限制每周期的相关处理能力。
分支预测 #
分支指令会改变后续执行路径。为了避免等待分支结果而停止取指,处理器先预测执行方向,再沿预测路径继续处理。本实验使用 hashed_perceptron,根据历史分支行为预测是否跳转;basic_btb 是分支目标缓冲模块,用于预测跳转目标地址。预测错误时,错误路径上的工作需要撤销,因此分支预测准确率会影响 IPC。
缓存层次 #
缓存用于缩小 CPU 与主内存之间的访问速度差距。L1I 保存指令,L1D 保存程序数据,L2C 是下一级统一缓存。访问命中时直接取得数据,未命中时通常需要继续访问更低层的缓存或主内存。
sets 表示组数,ways 表示每组可容纳的缓存行数。一条缓存行按地址映射到某一组,并占用其中一路。缓存容量为“组数 × 路数 × 缓存行大小”;本版本默认缓存行为 64 B,因此 L1I 的 64 组 × 8 路对应 32 KiB,L1D 的 96 组 × 8 路对应 48 KiB,L2C 的 2048 组 × 16 路对应 2 MiB。
这三级缓存均采用 lru 替换策略:一组已满时,优先淘汰该组中最久未使用的缓存行。prefetcher: no 表示关闭预取,不提前猜测并加载未来可能访问的数据。mshr_size 指定跟踪未完成缓存未命中请求的条目数,L1I、L1D 各为 16,L2C 为 20,使缓存能够在等待数据返回期间继续处理其他请求;访问同一缓存行的多个请求可以合并。
最后,executable_name 指定编译产物为 bin/champsim-lab1。未显式指定的硬件参数由默认配置补全,包括更下层的 LLC 和 DRAM。这些配置决定模拟处理器的行为,宿主机性能主要影响完成模拟所需的实际时间。
生成配置并编译构建 #
在源码根目录执行:
./config.sh lab1_config.json
make -j "$(nproc)"
test -x bin/champsim-lab1 && echo "ChampSim compilation succeeded: bin/champsim-lab1"
./bin/champsim-lab1 --help
config.sh 根据 JSON 生成构建所需的配置及代码,make 将模拟器和选定模块编译为 bin/champsim-lab1。其中 -j "$(nproc)" 根据容器可用 CPU 核心数并行编译。检查文件具有执行权限,并确认 --help 正常输出命令行选项,可以验证编译产物能够启动。后续修改硬件配置时,需要重新生成配置并编译。
执行指令轨迹 #
该lab使用trace文件: traces/binary_search.champsimtrace.xz。首先可以先预热 100 万条指令,进行短测试,确认可执行文件和 trace 均可正常使用:
mkdir -p results

./bin/champsim-lab1 \
  --warmup-instructions 1000000 \
  --simulation-instructions 10000000 \
  traces/binary_search.champsimtrace.xz \
  2>&1 | tee results/results-part1.txt
将每一次的测试结果都保存在一个命名好了的文件中作记录,特别是进行正式测试时时间较长需要等待,只在终端打印容易丢失运行结果。除了用
tee外,还可用> result.txt。
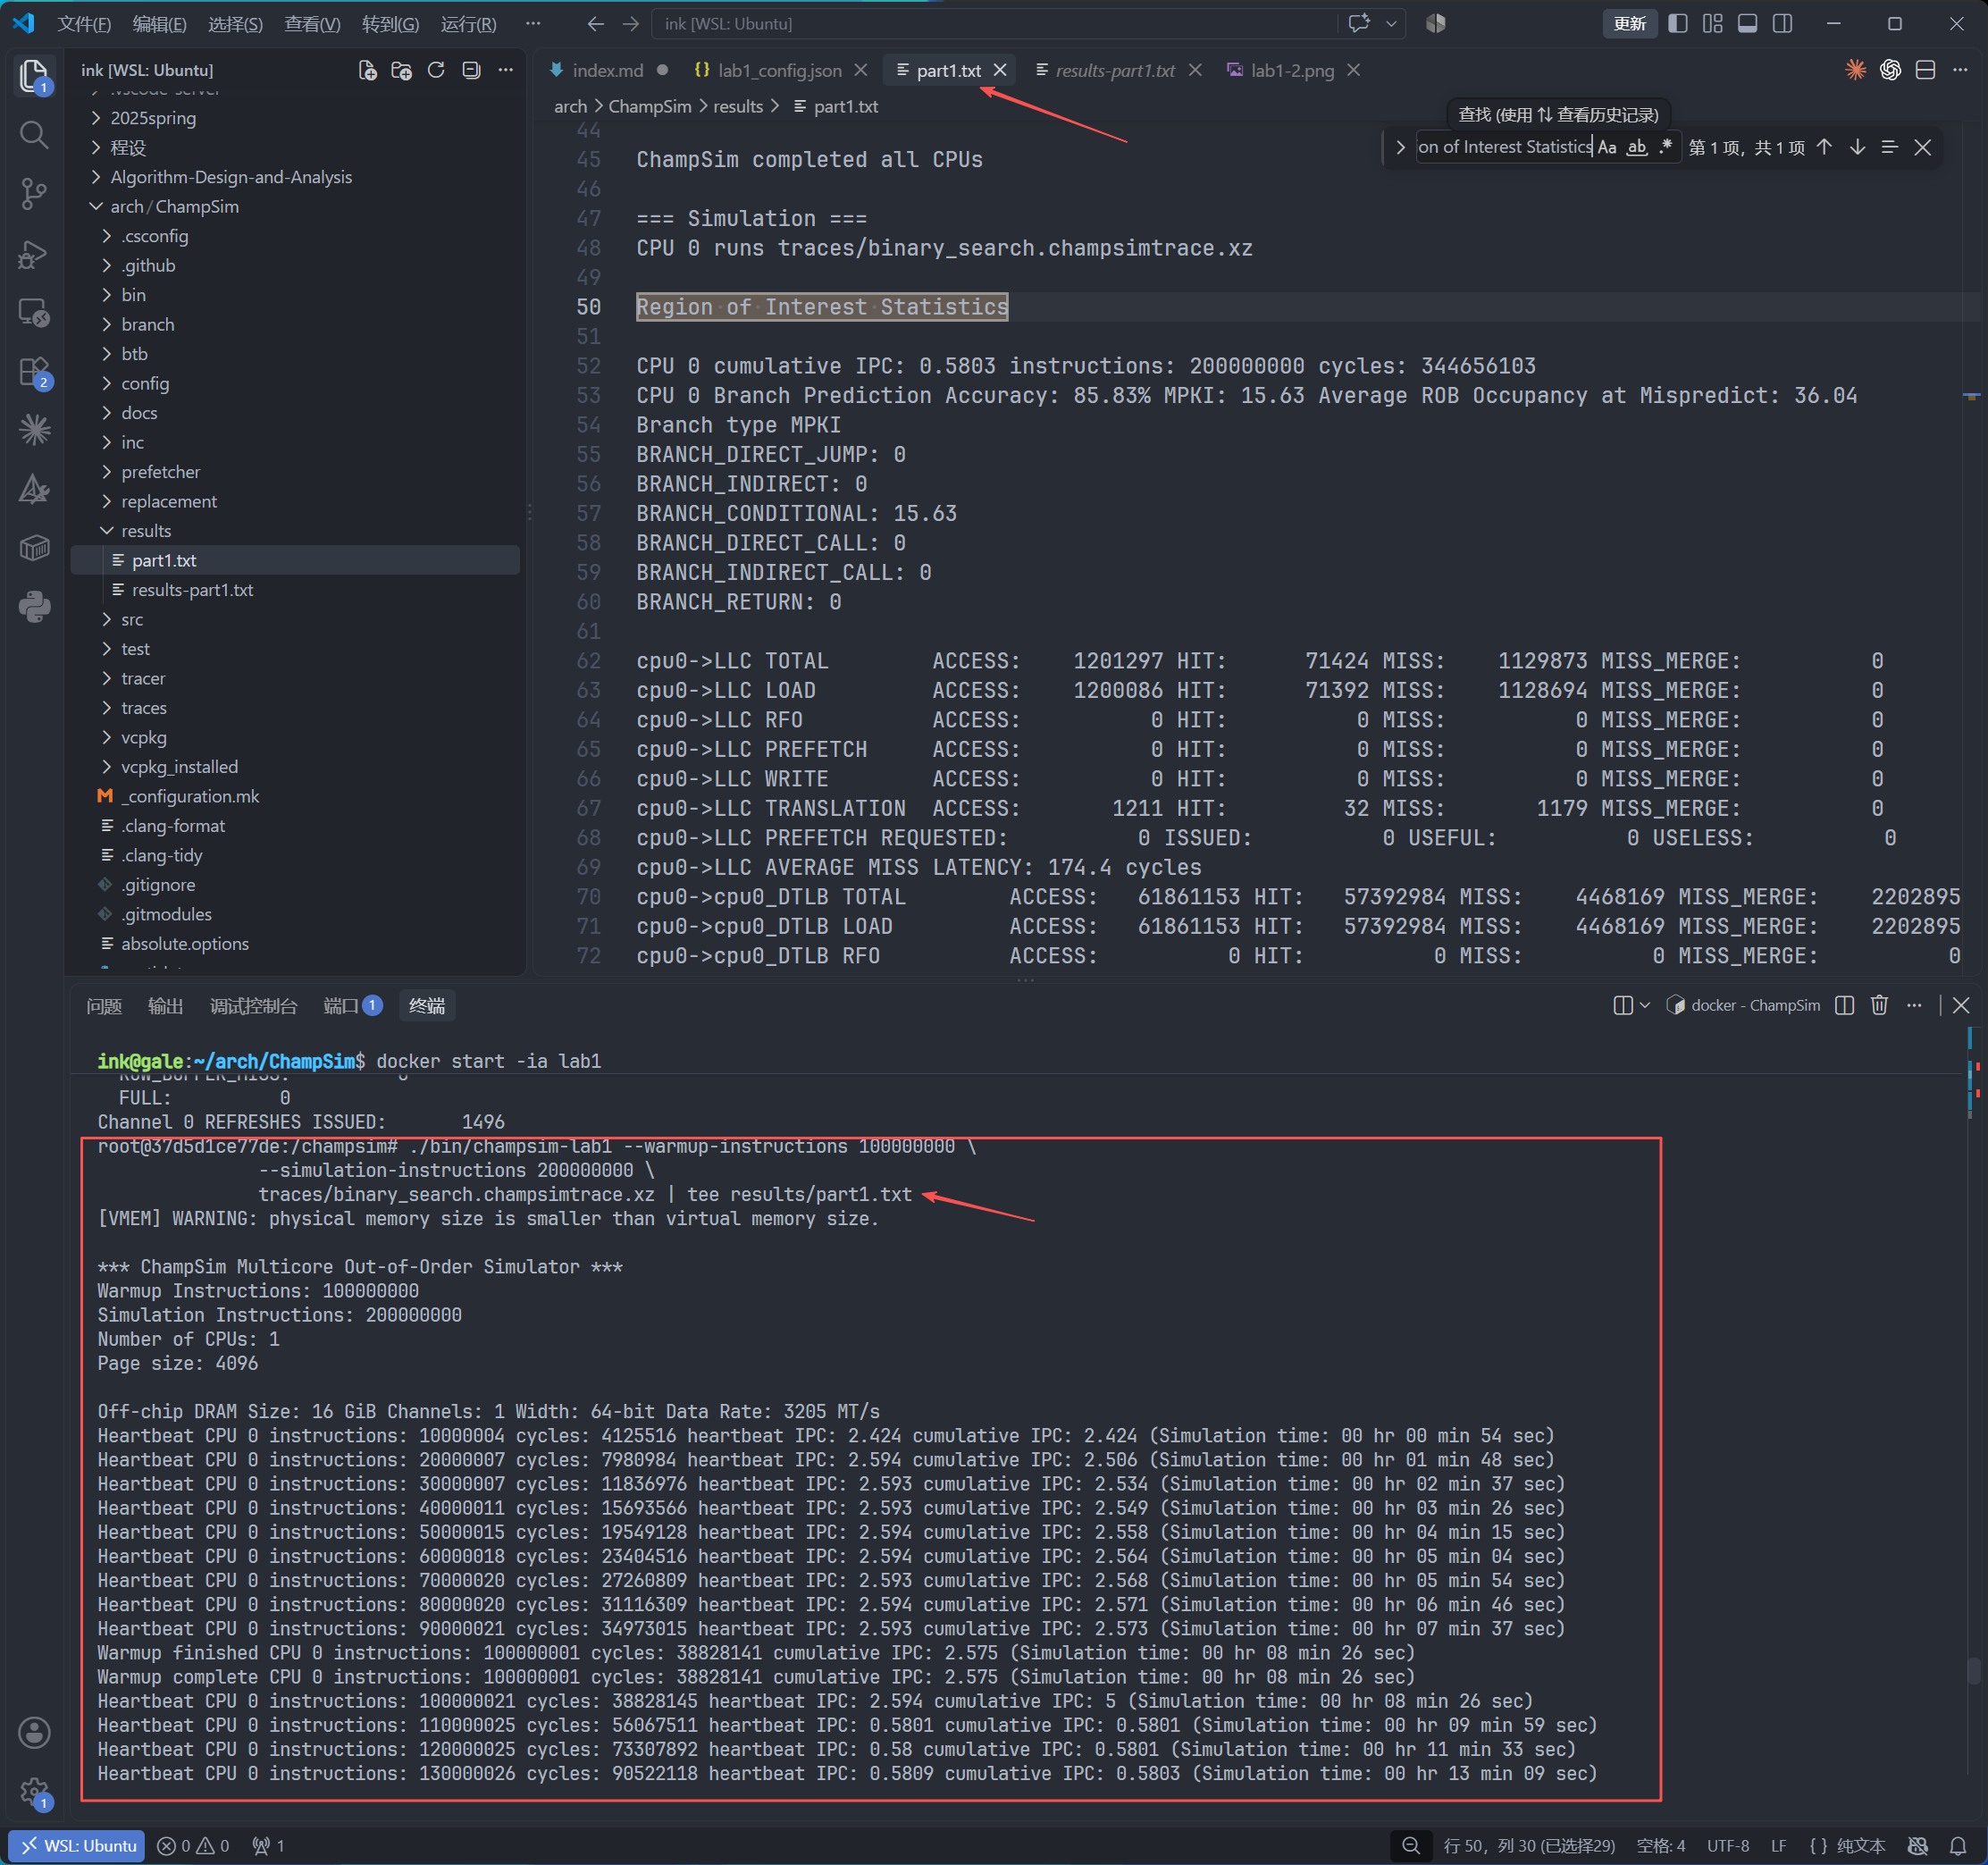
短测试正常完成后,将预热指令数增加到 1 亿、正式模拟指令数增加到 2 亿,保存正式实验输出:
./bin/champsim-lab1 \
  --warmup-instructions 100000000 \
  --simulation-instructions 200000000 \
  traces/binary_search.champsimtrace.xz \
  2>&1 | tee results/part1.txt
收集与解释统计结果 #
每次的运行结果包括几部分:
- 即将模拟的指令个数、cpu核数、页大小
- 具体的模拟时数据,包括
- Warmup阶段:先预热小部分指令,目的是让缓存和分支预测器充满状态。假设在正式模拟的时候没有进行预热,也就是冷启动,那么缓存是空的,刚开始的cache miss率会非常高;且由于分支预测器中没有历史状态,分支预测的成功率也会不那么准确。
- Simulation阶段:会输出每一小段的HeartBeat信息,显示的是运行时的实时数据;最终会有完整模拟的全部统计数据。
- Region of Interest Statistics:最终的统计数据,方便查看分析,可以使用
grep来找想要的数据。
一些重要的指标如下:
- IPC(Instruction per Cycle): 表示每个模拟 CPU 周期执行的
retired了的指令数,计算IPC = simulated instructions / simulated cycles。在正式实验中,200000000 / 344656103 ≈ 0.5803,与日志一致。
这里强调的是已经retired的指令,通常一条指令的完整过程是fetch -> decode -> dispatch -> execute -> retire,假设在分支预测时发生了错误,那些错误的指令即使已经被fetch / decode / dispatch / execute了,但只要还没有被retire来确认提交,都是还可以撤销的。 所以后面会提到,分支预测器的准确率在提高的情况下,需要撤销的指令就减少了,可以提高IPC。
- 有关缓存的数据:如L1D的缓存未命中率
L1D miss rate = L1D total misses / L1D total accesses,正式实验中的数据是:
cpu0->cpu0_L1D TOTAL ACCESS: 62147737 HIT: 56067873 MISS: 6079864 MISS_MERGE: 3047622因此可计算该缓存的未命中率为6079864 / 62147737 × 100% ≈ 9.78%。(上面信息中 ACCESS、HIT 和 MISS 分别表示访问、命中和未命中次数)
- (branch predictor’s BRANCH) MPKI(Misses per thousand Instructions): 这个项目中特指分支预测器的每一千条指令的分支预测错误数。我的这次模拟中分支预测 MPKI 为 15.63。此外,也有
Cache MPKI,指缓存的每一千条指令的缓存未命中数。
These statistics are particularly important when studying branch predictors, cache configurations, and hardware prefetchers. For example, a prefetcher may increase cache hits and reduce cache MPKI, while a branch predictor may reduce branch MPKI and improve IPC. Therefore, you should consider multiple statistics when evaluating the effectiveness of a configuration.
这段话也就是说,整个处理器的性能评估不能只看某一个指标。通过改变某一个配置项,在理论上会对一个指标有正向影响,但是对于IPC对影响却是不一定的。比如,开启prefetcher可以降低cache MPKI,但是对于IPC的影响不一定是正向的。这里可以进行实验来验证。
补充实验:预取器的 A/B 测试 #
本实验比较关闭预取和开启 next_line 预取的效果。next_line 尝试提前加载当前缓存行的下一行,但未必能降低未命中率或提高 IPC,需要通过实际结果判断。两组仅改变 L1D 预取器,其他硬件参数、trace 和模拟指令数保持一致。以下命令均在容器内的 ChampSim 源码根目录执行。
1. 准备两份配置 #
复制原配置,将配置与后续日志统一保存在 results/abtest/:
mkdir -p results/abtest
cp lab1_config.json results/abtest/config-no.json
cp lab1_config.json results/abtest/config-next_line.json
在 VS Code 中修改两份文件:
config-no.json:将executable_name改为champsim-ab-no,保持L1D.prefetcher为no。config-next_line.json:将executable_name改为champsim-ab-next_line,只将L1D下的prefetcher改为next_line,L1I 和 L2C 保持不变。
2. 分别编译 #
为两组配置生成不同名称的可执行文件,便于同时运行:
./config.sh results/abtest/config-no.json &&
make -j2 &&
./config.sh results/abtest/config-next_line.json &&
make -j2
成功后得到 bin/champsim-ab-no 和 bin/champsim-ab-next_line。配置生成和编译依次进行,避免修改同一目录中的共享构建文件。
3. 并行运行并保存结果 #
两组都使用 binary_search trace,预热 1 亿条指令,再统计 2 亿条指令。& 将任务放到后台,两组模拟可以并行执行:
./bin/champsim-ab-no \
  --warmup-instructions 100000000 \
  --simulation-instructions 200000000 \
  traces/binary_search.champsimtrace.xz \
  > results/abtest/no.txt 2>&1 &
pid_no=$!

./bin/champsim-ab-next_line \
  --warmup-instructions 100000000 \
  --simulation-instructions 200000000 \
  traces/binary_search.champsimtrace.xz \
  > results/abtest/next_line.txt 2>&1 &
pid_next=$!

wait "$pid_no"
status_no=$?
wait "$pid_next"
status_next=$?
printf 'no exit: %s; next_line exit: %s\n' "$status_no" "$status_next"
保持终端和容器运行,等待两组任务结束。退出码均为 0,且下面的命令在两份日志中都找到完成标记,说明运行正常:
grep "ChampSim completed all CPUs" results/abtest/no.txt results/abtest/next_line.txt两份模拟结果分别保存在 no.txt 和 next_line.txt。并行运行可能增加实际耗时,性能比较应使用模拟 IPC 和周期数。
4. 提取指标并比较 #
从最终 ROI 统计中查看 IPC、L1D 需求读取未命中数和预取统计:
grep -E 'CPU 0 cumulative IPC|cpu0_L1D (LOAD |PREFETCH |AVERAGE MISS LATENCY)' \
  results/abtest/no.txt results/abtest/next_line.txt
使用 LOAD MISS 计算需求读取 MPKI,避免把预取请求自身的未命中混入比较:
L1D LOAD MPKI = L1D LOAD MISS / ROI 指令数 × 1000
IPC 提升率 = (IPC_next_line / IPC_no − 1) × 100%| 指标 | 关闭预取(no) | 开启预取(next_line) |
|---|---|---|
| ROI 指令数 | 200,000,000 | 200,000,001 |
| ROI 周期数 | 344,656,103 | 358,473,946 |
| IPC | 0.5803 | 0.5579 |
| L1D LOAD MISS | 5,964,358 | 6,063,425 |
| L1D LOAD MPKI | 29.8218 | 30.3171 |
| L1D 平均未命中延迟 | 83.48 cycles | 91.79 cycles |
| L1D 预取 ISSUED / USEFUL / USELESS | 0 / 0 / 0 | 40,820,986 / 223,712 / 2,330,419 |
| DRAM 读取请求数(RQ 行命中 + 行未命中) | 1,129,873 | 2,220,797 |
两组退出码均为 0,并输出完整 ROI 统计。除可执行文件名外,配置仅在 L1D.prefetcher 上不同。开启预取的一组多退休 1 条指令,是按周期判断结束条件产生的轻微超额;上表 MPKI 按各自实际 ROI 指令数计算。IPC 变化率使用指令数与周期数计算出的未舍入 IPC,约为 −3.85%,模拟周期数增加约 4.01%。两组分支预测准确率均为 85.83%,分支 MPKI 均为 15.63。
本次 next_line 没有减少需求读取未命中:L1D LOAD MPKI 从 29.8218 上升到 30.3171,增加约 1.66%。同时,L1D 平均未命中延迟升高,DRAM 读取请求数增加约 96.55%。虽然 L1D 的总命中次数从 56,067,873 增加到 91,501,110,但其中包含新增预取请求的命中,不能据此认定程序的需求访问得到改善。平均未命中延迟同样是混合请求统计,不能直接解释为每次需求读取的等待时间。
next_line 假设相邻缓存行很快会被访问,而二分查找的下一次访问由比较结果决定,并不总是落在相邻缓存行。本次日志记录了 223,712 次有用预取和 2,330,419 次未使用即被淘汰的预取缓存行,说明确有部分收益,但也有较多无效预取。ISSUED 还包含命中已有缓存行或被合并等情况,不能直接把 ISSUED − USEFUL 全部视为无用预取。
额外的下层访存流量与延迟上升,支持预取引入资源竞争的解释;需求未命中增加也可能与缓存污染有关,但仅凭这些汇总统计无法分别量化两者的贡献。可以确定的是:在当前 binary_search trace 和硬件配置下,开启 L1D next_line 预取使 IPC 下降,不能将这一结果推广到所有程序或所有预取器。评估配置时,需要同时观察 IPC、需求缓存 MPKI 和额外访存开销。