llm #
语言模型 #
用概率描述语言的规律性。训练过程是利用大量文本数据学习这些概率分布的参数。
例如,在一个简单的二元语言模型中,给定一个单词序列
$$w_1,w_2...,w_n$$,其概率可以表示为
$$ P(w_1,w_2,...w_n) = \prod_{i=1}^{n} P(w_i|w_{i-1}) $$其中
$$P(w_i|w_{i-1})$$表示在已知前一个词的情况下,当前词出现的概率。
大语言模型 #
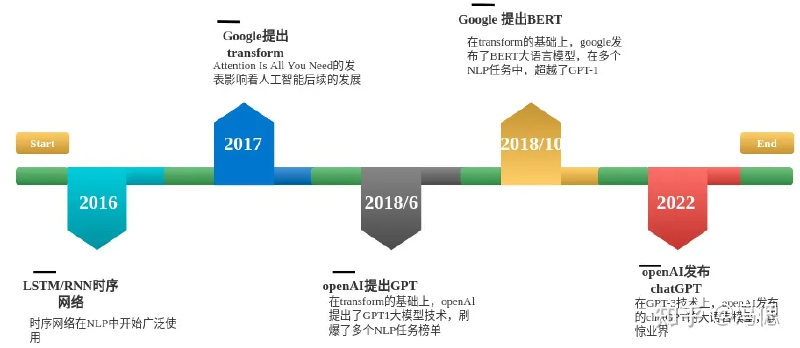
- RNN 循环神经网络
神经网络,也称为人工神经网络 (ANN) 或模拟神经网络 (SNN),是机器学习的一个子集,也是深度学习算法的核心。
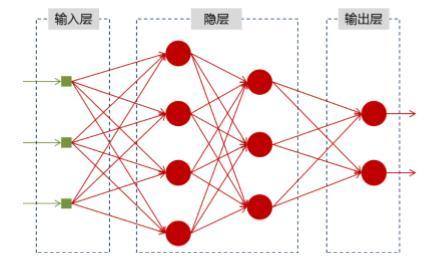
人工神经网络 (ANN) 由节点层组成,包含一个输入层、一个或多个隐藏层和一个输出层。 每个节点也称为一个人工神经元,它们连接到另一个节点,具有相关的权重和阈值。 如果任何单个节点的输出高于指定的阈值,那么该节点将被激活,并将数据发送到网络的下一层。 否则,不会将数据传递到网络的下一层。
神经网络依靠训练数据来学习和随时间推移提高自身精度。 然而,这些学习算法经过精度调优后,就会成为计算机科学和人工智能领域中的强大工具,可支持我们快速进行数据分类和分组。 语音识别或图像识别方面的任务可能仅需几分钟即可完成,而由人类专家手动识别可能需要数小时时间。 最著名的神经网络之一是 Google 的搜索算法。
神经网络可以当做是能够拟合任意函数的黑盒子,只要训练数据足够,给定特定的x,就能得到希望的y,结构图如下:
那为什么还需要RNN呢?因为对于神经网络,只能单独去处理一个个的输入,前一个输入和后一个输入是完全没有关系的。但是,某些任务需要能够更好的处理序列的信息,即前面的输入和后面的输入是有关系的。为了解决一些这样类似的问题,能够更好的处理序列的信息,RNN(循环神经网络)就诞生了。
一个简单的RNN结构如下:
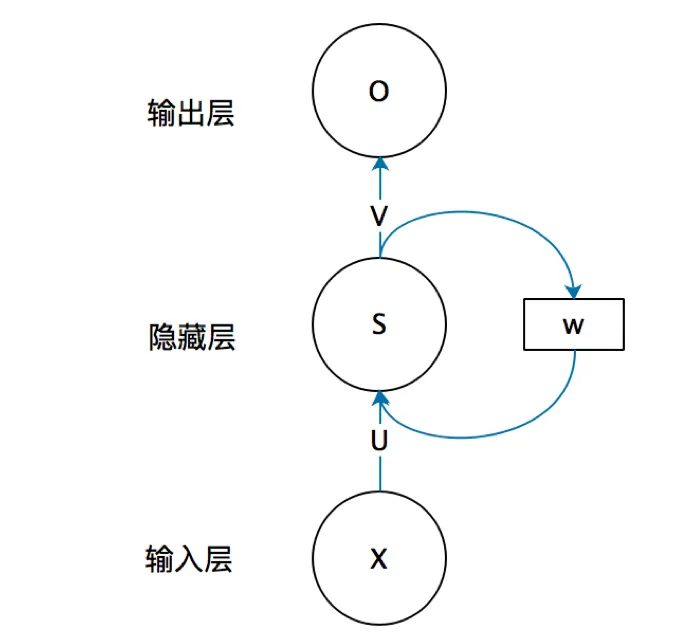
如果把上面有W的那个带箭头的圈去掉,它就变成了最普通的全连接神经网络。x是一个向量,它表示输入层的值(这里面没有画出来,表示为神经元节点的圆圈);s是一个向量,它表示隐藏层的值(这里隐藏层面画了一个节点,你也可以想象这一层其实是多个节点,节点数与向量s的维度相同);U是输入层到隐藏层的权重矩阵,o也是一个向量,它表示输出层的值;V是隐藏层到输出层的权重矩阵。
循环神经网络的隐藏层的值s不仅仅取决于当前这次的输入x,还取决于上一次隐藏层的值s。权重矩阵 W就是隐藏层上一次的值作为这一次的输入的权重。
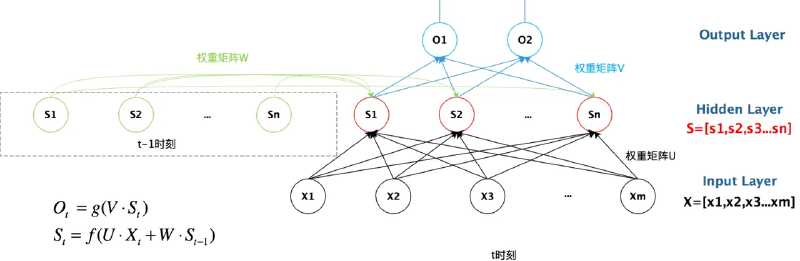
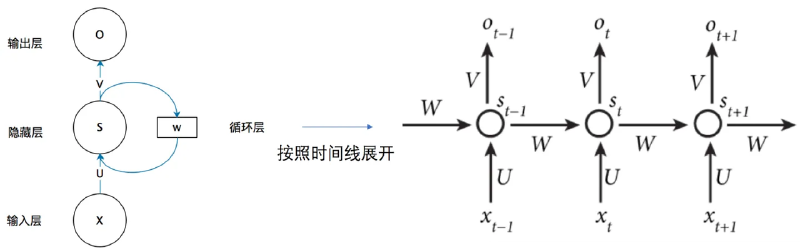
关键点是,St的值不仅仅取决于 Xt,还取决于 St−1。
- Transformer 网络
Transformer是一种用于序列建模的深度神经网络结构,它在自然语言处理领域中得到了广泛应用。相对于传统的递归或卷积方式,Transformer采用了全局的注意力机制,能够更好地捕捉序列中不同位置之间的依赖关系;同时相比RNN,Transformer在并行计算有明显优势。
Transformer的核心结构是 **多头注意力层(Attention) + MLP层(Multilayer Perceptron)**交替堆叠。
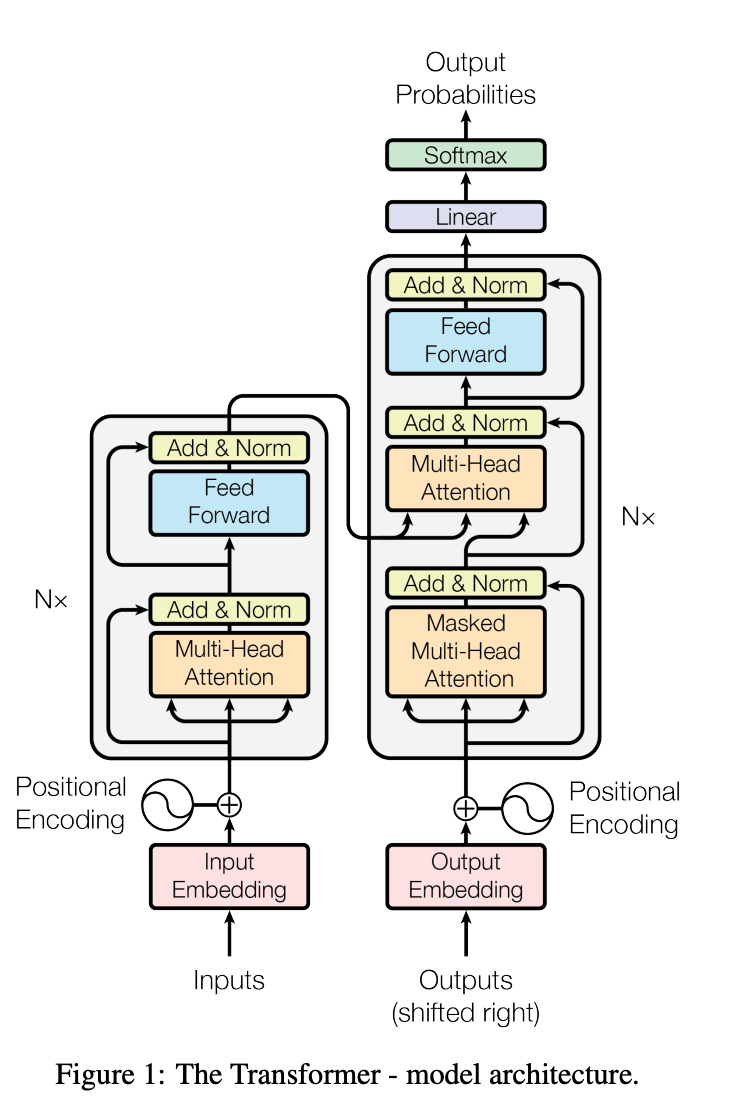
- Transformer的输入
单词的输入表示x为一个向量,由单词Embedding和位置Embedding相加得到。
embedding 过程,就是将 token 进行多维化表达的过程,不同的 token 在不同的语义下面,会有不同的含义。
单词Embedding:单词的 Embedding 有很多种方式可以获取,例如可以采用 Word2Vec、Glove 等算法预训练得到,也可以在 Transformer 中训练得到。
位置Embedding:表示单词出现在句子中的位置。因为 Transformer 不采用 RNN 的结构,而是使用全局信息,不能利用单词的顺序信息,而这部分信息对于 NLP 来说非常重要。所以 Transformer 中使用位置 Embedding 保存单词在序列中的相对或绝对位置。
位置 Embedding 用 PE表示,PE 的维度与单词 Embedding 是一样的。PE 可以通过训练得到,也可以使用某种公式计算得到。在 Transformer 中采用了后者,计算公式如下:
$$ PE_{(pos, 2i)} = \sin(pos/10000^{2i/d}) $$$$ PE_{(pos, 2i+1)} = \cos(pos/10000^{2i/d}) $$其中,pos 表示单词在句子中的位置,d 表示 PE的维度 (与词 Embedding 一样),2i 表示偶数的维度,2i+1 表示奇数维度 (即 2i≤d, 2i+1≤d)。使用这种公式计算 PE 有以下的好处:
- 使 PE 能够适应比训练集里面所有句子更长的句子,假设训练集里面最长的句子是有 20 个单词,突然来了一个长度为 21 的句子,则使用公式计算的方法可以计算出第 21 位的 Embedding。
- 可以让模型容易地计算出相对位置,对于固定长度的间距 k,PE(pos+k) 可以用 PE(pos) 计算得到。因为 Sin(A+B) = Sin(A)Cos(B) + Cos(A)Sin(B), Cos(A+B) = Cos(A)Cos(B) - Sin(A)Sin(B)。 将单词的词 Embedding 和位置 Embedding 相加, 就是 Transformer 的输入。
- 自注意力层(Attention)
哈利波特 出现时,你会联想到「闪电伤疤」「霍格沃茨」等元素,无论这些词相隔多少页。Transformer 的自注意力层正是这种能力的数字化实现——每个词瞬间与全文所有词建立关联权重,形成动态关系网。